
Elasticsearch для тех, кто пришёл из SQL и Redis: документы, шарды и бакеты
Elasticsearch - это распределённая система поиска и аналитики по документам. Внутри у неё библиотека Apache Lucene, а снаружи HTTP API с JSON. Если PostgreSQL отвечает на вопрос «дай строки по условию», а Redis - «дай значение по ключу», то Elasticsearch отвечает на вопрос «найди документы по словам, отфильтруй и сразу посчитай, как они распределяются по группам».
Документ, индекс и mapping
Основная единица данных в Elasticsearch - документ. Это обычный JSON. Вот заказ интернет-магазина:
{
  "order_id": 1001,
  "country": "EE",
  "status": "paid",
  "amount": 100.0,
  "description": "Беговые кроссовки Nike, размер 42",
  "created_at": "2026-10-20T14:30:00Z"
}
Документы складываются в индекс, например orders. Если сравнивать с SQL, индекс ближе всего к таблице: это коллекция однотипных записей, у которой есть схема.
Схема индекса называется mapping. Она говорит, как хранить и индексировать каждое поле:
| Поле | Тип | Зачем такой тип |
|---|---|---|
order_id | long | Целое число: точные сравнения и диапазоны |
country | keyword | Код страны целиком: фильтр country = EE, группировка по странам |
status | keyword | Значение из короткого списка: paid, cancelled |
amount | double | Число: суммы, средние, диапазоны цен |
description | text | Свободный текст, по которому ищут словами |
created_at | date | Дата: фильтры «за неделю», группировка по дням |
Самое важное различие для новичка - text против keyword:
- text при записи разбивается на отдельные слова. Строку «Беговые кроссовки Nike» можно найти по слову «nike». Зато группировать по такому полю нельзя: непонятно, по какому из слов.
- keyword хранится целиком, как одно значение. Найти
"EE"можно только точным совпадением, зато по нему удобно фильтровать, сортировать и группировать.
Тип поля после создания поменять обычно нельзя: для этого создают новый индекс с новым mapping и переливают данные (reindex).
Почему поиск быстрый: инвертированный индекс
Обычная таблица устроена «документ → его слова»: чтобы найти все заказы со словом «nike», пришлось бы прочитать каждое описание. Lucene при записи строит обратную структуру: слово → список документов, где оно встречается. Это и называется инвертированным индексом. Поиск по слову превращается в чтение одного готового списка, а поиск по двум словам - в пересечение двух списков.
Документы
Термы в индексе
Тот же индекс в виде таблицы:
| Терм | Документы |
|---|---|
| кроссовки | 1, 2 |
| nike | 1, 3 |
| adidas | 2, 4 |
| куртка | 3, 4 |
| беговые | 1 |
| беговая | 3 |
Превращение текста в термы называется анализом: строка разбивается на слова, приводится к нижнему регистру, иногда слова сводятся к основе. Обратите внимание на «беговые» и «беговая»: без настройки это два разных терма, и поиск по одному не найдёт другой. Для русского языка анализатор нужно выбрать и настроить самостоятельно, автоматической магии нет.
Кластер, шарды и реплики
| Понятие | Что это |
|---|---|
| Кластер | Все серверы Elasticsearch, которые работают вместе как одна система |
| Узел (node) | Один процесс Elasticsearch, обычно один сервер |
| Primary shard | Часть индекса. Каждый документ живёт ровно в одном primary-шарде |
| Replica | Копия primary-шарда на другом узле: для отказоустойчивости и для чтения |
Индекс orders можно разрезать, например, на три шарда и дать каждому по одной реплике. Elasticsearch раскладывает их так, чтобы копия никогда не лежала на том же узле, что и оригинал:
Шард - это физическое размещение части данных: «вот эти документы лежат вот на этом узле». Технически каждый шард - отдельный индекс Lucene со своим инвертированным индексом.
Как проходит запись
- Любой узел принимает запрос на запись документа.
- Он определяет нужный шард по
_idдокумента (в API это id документа, его можно задать равнымorder_id): хэш от_idпо модулю числа primary-шардов. Поэтому число primary-шардов нельзя просто так поменять у существующего индекса. - Запрос уходит на узел с primary-шардом. Primary записывает документ и рассылает операцию своим репликам.
- Клиент получает ответ, когда подтвердили запись нужное число копий шарда - сколько задано в
wait_for_active_shards(по умолчанию все активные: primary и реплики).
Как проходит поиск
- Узел, получивший запрос, становится координатором.
- Он отправляет запрос в одну копию каждого шарда: либо primary, либо реплику.
- Каждый шард выполняет поиск локально по своим данным.
- Координатор сливает частичные результаты в один ответ.
Реплики не удваивают результат: из каждого шарда в запросе участвует только одна копия.
refresh, которая по умолчанию происходит примерно раз в секунду. GET orders/_doc/1001 по известному _id читает документ напрямую и не ждёт refresh, в отличие от _search. Если тест пишет документ и тут же ищет его через _search, он может его не найти.Не путайте master-узел и primary-шард. Master управляет кластером: помнит, какие индексы есть и где лежат шарды, решает, куда переносить шарды при падении узла. Принимать все записи он не обязан, записи идут в primary-шарды, разбросанные по разным узлам.
Бакеты: GROUP BY в мире Elasticsearch
Теперь главное. Возьмём шесть заказов:
| order_id | country | status | amount |
|---|---|---|---|
| 1 | EE | paid | 100 |
| 2 | EE | paid | 200 |
| 3 | EE | cancelled | 40 |
| 4 | DE | paid | 80 |
| 5 | DE | cancelled | 50 |
| 6 | LV | paid | 120 |
Задача: сколько оплаченных заказов и на какую сумму в каждой стране? В SQL это GROUP BY. В Elasticsearch то же самое делает агрегация, а каждая получившаяся группа называется бакетом (bucket, «корзина»).
SELECT country,
       COUNT(*)    AS doc_count,
       SUM(amount) AS revenue
FROM orders
WHERE status = 'paid'
GROUP BY country;
GET orders/_search
{
  "size": 0,  // сами документы не нужны
  "query": {
    "term": { "status": "paid" }
  },
  "aggs": {
    "by_country": {
      "terms": { "field": "country" },
      "aggs": {
        "revenue": { "sum": { "field": "amount" } }
      }
    }
  }
}
Читается так: query - это WHERE, агрегация terms по полю country - это GROUP BY country, вложенная sum - это SUM(amount) внутри каждой группы. "size": 0 говорит «список найденных документов не возвращай, нужны только группы». Ответ (упрощённо):
"aggregations": {
  "by_country": {
    "buckets": [
      { "key": "EE", "doc_count": 2, "revenue": { "value": 300.0 } },
      { "key": "DE", "doc_count": 1, "revenue": { "value": 80.0 } },
      { "key": "LV", "doc_count": 1, "revenue": { "value": 120.0 } }
    ]
  }
}
Каждый бакет - это key (значение группы), doc_count (сколько документов попало в группу) и результаты вложенных агрегаций. По умолчанию бакеты отсортированы по doc_count от большего к меньшему.
query, группировка как агрегация terms. Зачёркнутые строки не прошли фильтр и в бакеты не попадают.Документы
| order_id | country | status | amount |
|---|
Бакеты
Ответ Elasticsearch
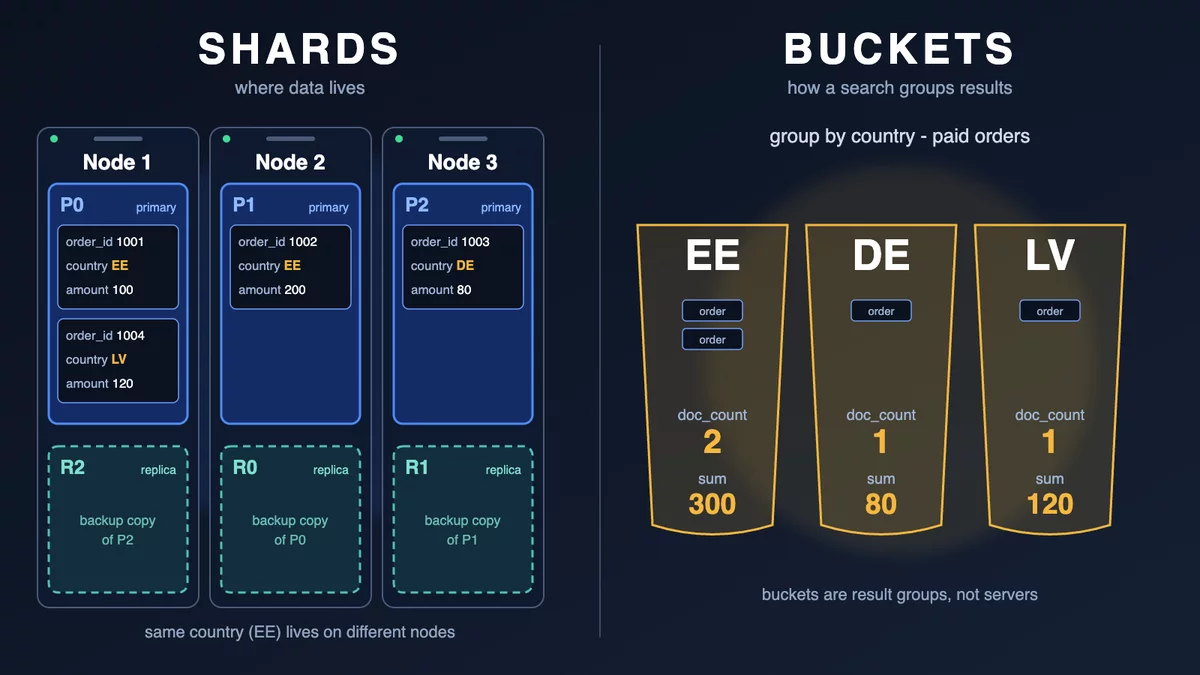
Теперь видно, почему шард и бакет - совсем разные вещи, хотя оба звучат как «части данных»:
| Шард | Бакет | |
|---|---|---|
| Что это | Размещение части индекса на узле | Группа документов в ответе на запрос |
| Когда существует | Постоянно, пока существует индекс | Рождается при выполнении запроса и исчезает после ответа |
| Откуда документы | Только документы этого шарда на одном узле | Собирается со всех шардов: каждый шард считает свои частичные бакеты, координатор их складывает |
| Кто решает | Настройки индекса и кластер | Ваш запрос |
EE.Основные виды бакетных агрегаций:
- terms - группа на каждое значение поля: по стране, по статусу, по бренду.
- date_histogram - группа на каждый интервал времени: заказы по дням или по месяцам.
- range - группы по диапазонам чисел: заказы до 50, от 50 до 150, больше 150.
- filters - группа на каждое заданное условие: «крупные заказы», «заказы из Балтии».
Две практические заметки:
- Один документ может попасть в несколько бакетов: например, в
filtersс пересекающимися условиями или если поле содержит массив тегов. Поэтому сумма всехdoc_countне всегда равна числу документов. termsвозвращает только top-N групп (параметрsize, по умолчанию 10). Чтобы перебрать все группы постранично, есть агрегацияcomposite.
Чем отличается от PostgreSQL
В PostgreSQL заказ, пользователь и товары лежат в разных таблицах и соединяются через JOIN. В Elasticsearch JOIN почти нет. Типы nested и parent-child существуют, но их используют редко - они тяжелее обычного документа; основной путь - денормализация, поэтому данные обычно денормализуют: кладут в документ всё, что нужно для поиска и отображения.
{
  "order_id": 1001,
  "user_id": 42,
  "user_name": "Анна Тамм",          // копия из таблицы users
  "product_names": ["Nike Pegasus 41", "Носки беговые"],  // копия из products
  "amount": 100.0
}
Цена такого подхода - дублирование. Если пользователь сменит имя, придётся обновить все его заказы в индексе, а не одну строку в users.
Второе отличие - нет транзакций на несколько документов. Запись одного документа атомарна, но пачка через _bulk может выполниться частично: 998 документов записались, 2 нет. Ответ _bulk нужно проверять поэлементно, а не только по общему статусу.
Честно стоит сказать и обратное: в PostgreSQL есть полнотекстовый поиск (tsvector), JSONB и GIN-индексы. Для поиска по каталогу на несколько тысяч товаров их часто достаточно. Elasticsearch оправдан, когда поиск становится отдельной тяжёлой нагрузкой: нужна настраиваемая релевантность, анализаторы под разные языки, фасеты и агрегации по миллионам документов, масштабирование на несколько серверов.
Чем отличается от Redis
Redis работает с известным ключом и структурами данных вокруг него:
GET  session:abc123                 # сессия по известному ключу
INCR views:product:42               # атомарный счётчик
ZADD leaderboard 1500 "user:7"     # сортированное множество
ZREVRANGE leaderboard 0 9          # топ-10
Elasticsearch работает с запросом по набору документов: «все оплаченные заказы из Эстонии со словом nike за неделю». Какие _id подойдут, заранее неизвестно, их находит поиск.
Redis держит данные в памяти, но умеет сохранять их на диск (RDB-снимки и AOF-журнал), поэтому при рестарте он не обязательно теряет всё: это зависит от настроек. Elasticsearch хранит поисковые структуры на диске и активно использует оперативную память и файловый кэш операционной системы, чтобы читать их быстро.
В Redis Cluster ключи распределяются по 16384 hash slots. Это про размещение данных по серверам, то есть аналог шардов, а не бакетов. Группировок результата в обычном Redis нет.
Для полноты: у Redis есть модуль поиска (Redis Search) с полнотекстовым поиском и агрегациями. Но это отдельная возможность со своими ограничениями, а не основной сценарий Redis.
Что выбрать и как их сочетать
| PostgreSQL | Elasticsearch | Redis | |
|---|---|---|---|
| Основная единица | Строка таблицы | JSON-документ | Ключ и значение |
| Типичная задача | Строки по условию | Поиск по словам и фильтрам | Значение по ключу |
| Группировки | GROUP BY | Агрегации и бакеты | Нет (кроме модулей) |
| Связи | JOIN, внешние ключи | Денормализация | Нет |
| Транзакции | Полноценные, на много строк | Только на один документ | MULTI/EXEC, скрипты |
| Назначение | Источник истины | Поиск и аналитика | Кэш, сессии, счётчики, очереди |
В реальном магазине их часто используют вместе:
- Данные, которые нельзя потерять и которые нужно менять транзакционно (заказы, деньги, остатки), храните в PostgreSQL. Это источник истины.
- Если нужен поиск по словам с релевантностью, фасетами и агрегациями по большому объёму, добавьте Elasticsearch как производную копию, которую всегда можно перестроить из PostgreSQL.
- Если нужно быстро получить значение по известному ключу (сессия, кэш, счётчик), используйте Redis.
И главное, что стоит унести из статьи: шард - это место, где лежит часть данных, а бакет - ответ на вопрос «на какие группы разбить найденные документы и что посчитать внутри каждой».