
Типы сетевых ошибок: что значит каждая и что с ней делать
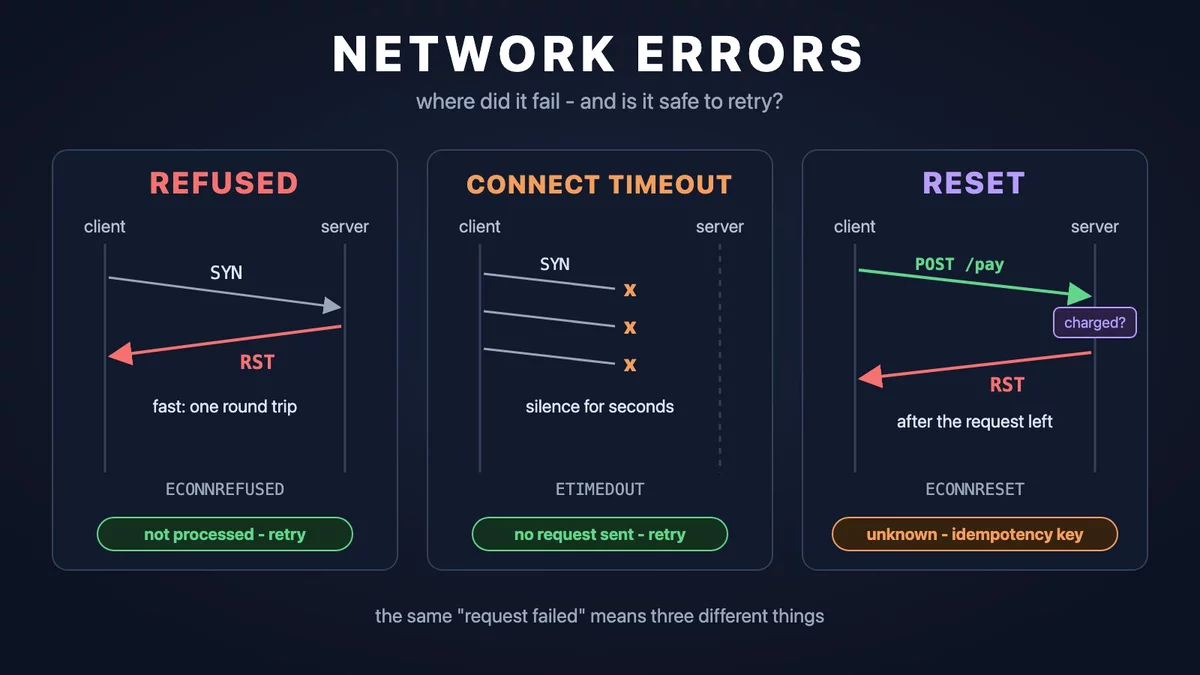
В логах все сетевые ошибки выглядят одинаково: «запрос не удался». Но connection refused означает «сервер точно ничего не получил», а connection reset после отправки - «я не знаю, что произошло». От этой разницы зависит, можно ли повторить запрос автоматически, или повтор спишет деньги с карты второй раз. В этой статье я разбираю, где рождается каждая ошибка, как её распознать по коду и по времени, когда повторять и как не уронить чужой сервис своими же повторами.
Путь одного запроса: слои
Когда код делает GET https://api.example.com/track/42, под капотом происходит несколько независимых шагов, и каждый может сломаться по-своему:
- DNS - перевод имени
api.example.comв IP-адрес. Это отдельный запрос к DNS-серверу ещё до любого соединения. - IP и маршрутизация - операционная система решает, через какой сетевой интерфейс и какой маршрутизатор (роутер) отправить пакет на этот адрес.
- TCP - установка соединения с конкретным портом (443 для HTTPS). TCP гарантирует, что байты дойдут целыми и по порядку.
- TLS - шифрование поверх TCP: стороны договариваются о ключах, клиент проверяет сертификат сервера.
- HTTP - сам запрос (метод, путь, заголовки, тело) и ответ со статусом.
- Приложение - бизнес-логика на сервере, которая может ответить ошибкой даже при идеальной сети.
Программа общается с сетью через сокет - объект операционной системы, похожий на открытый файл. Код вызывает системные функции вроде getaddrinfo() (DNS), connect() (установить соединение), write() и read(). Если вызов не удался, ядро возвращает числовой код ошибки - errno, у которого есть имя: ECONNREFUSED, ETIMEDOUT и так далее. Почти все HTTP-библиотеки во всех языках в итоге показывают вам именно эти имена, просто обёрнутые в свои классы исключений. DNS-функция getaddrinfo() - исключение: у неё свои коды с префиксом EAI_.
TCP за пять минут: SYN, ACK, RST и FIN
TCP-соединение начинается с тройного рукопожатия:
- Клиент отправляет пакет
SYN(«хочу соединиться»). - Сервер отвечает
SYN-ACK(«согласен, подтверждаю»). - Клиент отвечает
ACK. Соединение установлено, функцияconnect()возвращает успех.
Есть ещё два важных флага. FIN - вежливое закрытие: «я больше ничего не пришлю, но дочитаю то, что ты шлёшь». RST (reset) - аварийный обрыв: «такого соединения у меня нет» или «бросаю его немедленно». Стандарт TCP (RFC 9293) прямо требует: если пакет пришёл на порт, где никто не слушает, хост отвечает RST.
Теперь самое полезное. Неудачная попытка соединиться может выглядеть на проводе тремя разными способами:
- RST в ответ на SYN - хост жив, но на этом порту никто не слушает (приложение упало, перезапускается, слушает другой порт). Или firewall настроен «отклонять» (REJECT) и отвечает за хост. Ошибка приходит быстро, примерно за один RTT.
- Тишина - пакет куда-то пропал. Firewall настроен «молча отбрасывать» (DROP), хост выключен, таблица соединений на NAT переполнена. Ядро повторяет SYN с растущими паузами, и если вы не задали свой connect timeout, Linux сдаётся только примерно через две минуты (параметр
tcp_syn_retries, по умолчанию 6 повторов). - ICMP unreachable - служебное сообщение от роутера по дороге: «туда не доставить». Ядро превращает его в
EHOSTUNREACHилиENETUNREACH. Если firewall отвечает ICMP «port unreachable», клиент увидит ужеECONNREFUSED.
Словарь errno
Вот коды, которые встречаются на практике чаще всего. «Этап» - когда именно ошибка возникает.
| Код | Этап | Что произошло на проводе | Что это значит |
|---|---|---|---|
EAI_NONAME | DNS | DNS-сервер ответил «такого имени нет» (NXDOMAIN) | Опечатка в хосте, домен удалён, внутреннее имя не видно из этой сети. В Node.js это ENOTFOUND |
EAI_AGAIN | DNS | DNS-сервер не ответил или вернул временную ошибку | Проблема резолвера, обычно временная |
ECONNREFUSED | connect | Пришёл RST на наш SYN (или ICMP port unreachable) | Хост жив, порт никто не слушает |
ETIMEDOUT | connect или позже | Ответа нет: SYN или данные не подтверждаются | Пакеты теряются или отбрасываются. На живом соединении ядро выдаст это только через 13-30 минут неудачных повторов (tcp_retries2), поэтому обычно вы раньше видите таймаут своей библиотеки |
EHOSTUNREACH | connect | ICMP host unreachable, или в локальной сети никто не ответил на ARP | Хоста нет в сети или маршрут закрыт |
ENETUNREACH | connect | Обычно ничего не отправлено: в таблице маршрутов нет пути | Нет сети: интерфейс не поднят, нет маршрута по умолчанию, IPv6-адрес без IPv6-связности |
ECONNRESET | после connect | Пришёл RST на уже установленное соединение | Сервер, балансировщик или NAT оборвали соединение. Запрос мог уже обрабатываться |
EPIPE | запись | Пишем в соединение, которое уже закрыто или сброшено | Противоположная сторона ушла раньше, чем мы дописали. Рантаймы игнорируют сигнал SIGPIPE и превращают его в эту ошибку |
EADDRNOTAVAIL | connect | Ничего: ядро не смогло выбрать локальный порт | Кончились эфемерные порты, подробно ниже |
EMFILE / ENFILE | socket, accept | Ничего: не дали открыть новый дескриптор | Лимит открытых файлов процесса (ulimit -n) или всей системы |
EPERM / EACCES | connect | Ничего: пакет запретил локальный firewall или политика безопасности | Правило на вашей машине, а не у сервера |
Чтобы закрепить, вот интерактивная шпаргалка. Нажмите на ошибку и посмотрите, на каком этапе она возникает и можно ли её повторить.
По времени ошибки видно, кто ответил
Один и тот же код ошибки может прийти от разных участников. Здесь очень помогает длительность попытки, поэтому я всегда пишу её в лог вместе с классом ошибки.
| Время до ошибки | Что это значит | Кто, скорее всего, ответил |
|---|---|---|
| Меньше 1 мс | Пакет не покидал машину | Ваше собственное ядро: на localhost никто не слушает, нет маршрута, нет свободных портов или дескрипторов, локальный firewall |
| Около 1 RTT | Пакет дошёл, кто-то ответил RST или ICMP | Удалённый хост, его балансировщик или firewall с правилом REJECT. Сравните с временем успешных соединений к тому же хосту |
| Около 3 с в локальной сети | Ядро не дождалось ответа на ARP | Никто: хоста с таким IP в подсети нет (EHOSTUNREACH) |
| Ровно ваш connect timeout | Полная тишина | Никто: DROP на firewall, переполненный conntrack или NAT, выключенный хост, переполненная очередь SYN на сервере |
| Около 2 минут | Ядро исчерпало повторы SYN | Тоже никто, но это ещё и признак того, что вы не задали connect timeout |
ECONNREFUSED за балансировщиком - редкость, и если он появился, значит не слушает сам балансировщик или вы ходите на приложение напрямую.Стадии запроса: мог ли сервер это обработать?
Для решения о повторе важен не код ошибки сам по себе, а момент, в который она случилась. Есть одна граница, которую я называю точкой невозврата: момент, когда первый байт HTTP-запроса ушёл в сеть. До неё сервер физически не мог ничего сделать. После неё - мог.
| Стадия | Типичные ошибки | Сервер мог обработать? | Повтор |
|---|---|---|---|
| 1. DNS | EAI_NONAME, EAI_AGAIN | Нет | EAI_AGAIN - да. EAI_NONAME обычно ошибка конфигурации, повтор не поможет |
| 2. connect | ECONNREFUSED, connect timeout, EHOSTUNREACH | Нет | Да, с паузой |
| 3. TLS | handshake timeout, reset во время рукопожатия | Нет | Да. Но ошибку проверки сертификата повторять бессмысленно: она детерминирована |
| 4. Отправка запроса | EPIPE, ECONNRESET, write timeout | Возможно | Только идемпотентные |
| 5. Ожидание ответа | read timeout, ECONNRESET, 502, 504 | Вероятно да | Только идемпотентные |
| 6. Чтение тела | reset или таймаут посреди тела | Да, ответ уже пошёл | Только идемпотентные |
Отдельно про HTTP-статусы от прокси. 502 Bad Gateway и 504 Gateway Timeout - это сетевые ошибки, которые прокси пересказал вам словами HTTP: «я не смог получить ответ от приложения». Если приложение получило запрос и упало или задумалось, операция могла выполниться. Поэтому 502 и 504 я отношу к стадии 5. А 503 Service Unavailable и 429 Too Many Requests обычно означают «я отказался работать», особенно если в ответе есть заголовок Retry-After.
Повторы: когда можно и как правильно
Идемпотентность
Операция идемпотентна, если выполнить её два раза - то же самое, что выполнить один раз. «Установить статус заказа в shipped» идемпотентно. «Списать 10 евро» - нет: два раза это 20 евро.
Стандарт HTTP (RFC 9110) называет идемпотентными методы GET, HEAD, OPTIONS, TRACE, PUT и DELETE, и прямо говорит, что клиенту не стоит автоматически повторять неидемпотентный запрос, если он не знает, что это безопасно. POST и PATCH по умолчанию неидемпотентны. Важно, что это обещание сервера, а не свойство метода: кривой API может списывать деньги на GET, и HTTP вас от этого не защитит.
Чтобы безопасно повторять POST, используют ключ идемпотентности. Клиент генерирует уникальный ключ на одну логическую операцию и шлёт его во всех попытках. Сервер запоминает ключ и результат, и на повтор с тем же ключом возвращает сохранённый ответ вместо повторного списания. Этот подход давно используют платёжные провайдеры, а в IETF есть черновик стандарта заголовка Idempotency-Key.
# один и тот же ключ во всех попытках
POST /payments HTTP/1.1
Host: api.example.com
Idempotency-Key: 8e03978e-40d5-43e8-bc93-6894a57f9324
Content-Type: application/json

{"order_id": 1001, "amount": 1000, "currency": "EUR"}
Ключ нужно сгенерировать до первой попытки и сохранить вместе с операцией. Если генерировать новый ключ при каждом повторе, он бесполезен.
Отсюда два режима доставки, о которых стоит договориться с собой явно:
- At-most-once (не больше одного раза) - не повторяем после точки невозврата. Иногда операция теряется, но никогда не выполняется дважды.
- At-least-once (хотя бы один раз) - повторяем, пока не получим подтверждение. Операция может выполниться дважды, поэтому получатель обязан уметь отбрасывать дубликаты. Ключ идемпотентности превращает at-least-once в «эффективно ровно один раз».
Повторять или нет: схема решения
Пауза между попытками: экспоненциальный backoff и jitter
Повторять мгновенно - плохая идея. Если сервис упал от перегрузки, мгновенные повторы от всех клиентов добьют его окончательно. Стандартный рецепт - экспоненциальный backoff: каждая следующая пауза вдвое длиннее (0,5 с, 1 с, 2 с, 4 с...) с верхним пределом.
Но одного backoff мало. Если тысяча клиентов получила ошибку одновременно, они и повторят одновременно, через ровно 0,5 с, потом через 1 с, и так волнами. Поэтому добавляют jitter - случайный разброс. Самый простой и хороший вариант «full jitter»: пауза - случайное число от нуля до экспоненциального предела.
# attempt = 0, 1, 2, ...
sleep = random(0, min(cap, base * 2 ** attempt))

# base = 0.5 s, cap = 10 s:
# attempt 0: 0..0.5 s
# attempt 1: 0..1 s
# attempt 2: 0..2 s
# attempt 5: 0..10 s (упёрлись в cap)
Бюджет повторов и шторм повторов
Повторы умножаются по слоям. Пусть браузер делает 3 попытки, ваш API-сервер на каждую делает 3 попытки к сервису заказов, а тот на каждую - 3 попытки к базе. Одно нажатие кнопки превращается в 3 × 3 × 3 = 27 запросов к базе, и ровно в тот момент, когда база и так не справляется. Это называется шторм повторов (retry storm).
Правила, которые помогают:
- Повторять в одном слое. Обычно там, где больше всего контекста: знаем ли мы про идемпотентность, сколько времени осталось у пользователя.
- Ограничить число попыток. В книге Google SRE предлагают не больше трёх попыток на запрос.
- Ограничить долю повторов. Там же предлагается бюджет на клиента: повторы не должны превышать примерно 10% от всех запросов. Когда сервис лежит целиком, это автоматически превращает повторы в тонкую струйку вместо потопа.
- Общий дедлайн. Ограничивать надо не только число попыток, но и общее время. Нет смысла делать третью попытку, если пользователь уже ушёл со страницы.
Circuit breaker
Circuit breaker («автоматический выключатель», как в электрощитке) - обёртка вокруг вызова внешнего сервиса, которая считает ошибки. Если доля ошибок за последнее время превысила порог, выключатель «размыкается»: следующие вызовы сразу завершаются ошибкой, не трогая сеть. Через некоторое время он пропускает пробный запрос, и если тот успешен, «замыкается» обратно. Это защищает и ваш сервис (потоки не висят в ожидании таймаутов), и чужой (он получает передышку для восстановления).
429, 503 и Retry-After
Статус 429 Too Many Requests (RFC 6585) означает «вы превысили лимит запросов», 503 Service Unavailable - «я временно не могу работать». Оба могут сопровождаться заголовком Retry-After: числом секунд или датой, после которой стоит повторить. Если сервер его прислал, его надо уважать и не повторять раньше. Хорошие библиотеки повторов делают это сами, но проверьте: не все включают это по умолчанию.
Иерархия таймаутов
«Таймаут» - это не одна настройка, а несколько, и каждая защищает от своего:
| Таймаут | Что ограничивает | Что будет, если не задать |
|---|---|---|
| connect | Установку TCP-соединения | Linux ждёт около двух минут при тишине |
| TLS handshake | Рукопожатие TLS | Зависание на сервере, который принял TCP, но молчит |
| write | Отправку запроса, особенно большого тела | Зависание, если получатель перестал читать |
| read | Ожидание следующей порции данных | Бесконечное ожидание ответа |
| Общий дедлайн | Всю операцию целиком, включая все повторы | Сумма всех остальных таймаутов, умноженная на число попыток |
Одна ошибка или серия
Одна ECONNREFUSED среди тысяч успешных запросов - это почти всегда перезапуск: деплой, перекат контейнера, балансировщик ещё пару мгновений слал трафик на выключающийся экземпляр. Её надо повторить и забыть. Серия ошибок подряд - совсем другая история: сервис лежит, вас заблокировали, у вас кончились порты. Повторы здесь не помогут, нужен человек.
Из этого вытекают два практических правила. Первое: в пакетной обработке (например, обновить статусы тысячи посылок) одна сетевая ошибка не должна прерывать весь пакет. Ловите ошибку на уровне одного элемента, считайте неудачи и идите дальше. Второе: алертинг стоит строить на доле ошибок за окно времени, а не на каждом отдельном исключении.
Пулы соединений и лимиты ресурсов
Keep-alive и пул
Устанавливать новое соединение на каждый запрос дорого: DNS, TCP-рукопожатие, TLS-рукопожатие - это несколько RTT до первого байта запроса. Поэтому HTTP/1.1 по умолчанию держит соединение открытым после ответа (keep-alive), а библиотеки складывают такие соединения в пул и переиспользуют для следующих запросов к тому же хосту.
У пула есть характерная проблема - протухшее соединение. Сервер не хочет вечно держать простаивающие соединения и закрывает их через свой idle timeout. Клиент может не успеть это заметить и взять из пула уже закрытое соединение:
Точная ошибка зависит от того, что успело прийти: если клиент уже получил FIN, чтение вернёт конец потока (EOF, «socket hang up» в Node.js), если RST - ECONNRESET, а следующая запись после RST - EPIPE. Хорошая новость: в этом сценарии сервер запрос не обработал, потому что соединение было закрыто ещё до него. Плохая: клиент не может отличить это от обрыва посреди настоящей обработки. Поэтому библиотеки повторяют автоматически только идемпотентные запросы.
Как лечить:
- Idle timeout клиента должен быть меньше, чем у сервера. Тогда соединение всегда закрывает клиент, а не сервер. Для ориентира: в nginx
keepalive_timeoutпо умолчанию 75 секунд, у HTTP-сервера Node.jskeepAliveTimeout- 5 секунд, у Puma в текущих версияхpersistent_timeout- 65 секунд. Значения меняются от версии к версии, проверяйте свою. - Балансировщик посередине. У него свой idle timeout на каждую сторону. Правило то же: idle timeout приложения за балансировщиком должен быть больше, чем у балансировщика, а у клиента - меньше.
Размер пула на хост
Обычно пул ограничен по числу соединений к одному хосту. Если параллельных запросов больше, лишние либо ждут свободного соединения, либо открывают временные, которые после ответа закрываются. Второй вариант при высокой нагрузке приводит к постоянному открытию и закрытию соединений и к проблеме из следующего раздела. В Go этот лимит по умолчанию всего 2 простаивающих соединения на хост, к этому вернёмся ниже.
Эфемерные порты, TIME_WAIT и EADDRNOTAVAIL
Каждое TCP-соединение однозначно определяется четвёркой: IP клиента, порт клиента, IP сервера, порт сервера (4-tuple). Порт сервера фиксирован (443), а порт клиента ядро выбирает автоматически из диапазона эфемерных портов. В Linux по умолчанию это 32768-60999 (параметр net.ipv4.ip_local_port_range), то есть 28 232 порта.
После закрытия соединения сторона, которая закрыла первой, держит его в состоянии TIME_WAIT: в Linux это 60 секунд. Это нужно, чтобы опоздавшие пакеты старого соединения не попали в новое с той же четвёркой. Всё это время порт занят.
Посчитаем: если клиент открывает новое соединение на каждый запрос к одному и тому же IP:порт и сам его закрывает, то 28 232 порта / 60 секунд ≈ 470 новых соединений в секунду - это потолок. Выше него connect() возвращает EADDRNOTAVAIL («Cannot assign requested address»). Лечится это не тюнингом ядра, а переиспользованием соединений через пул. Параметр net.ipv4.tcp_tw_reuse позволяет переиспользовать TIME_WAIT для исходящих соединений, но в текущих ядрах по умолчанию он включён только для loopback, и документация ядра советует не трогать его без экспертов.
Файловые дескрипторы
Каждый сокет в Unix - это файловый дескриптор. У процесса есть лимит открытых дескрипторов (смотрится через ulimit -n, часто это 1024 по умолчанию в оболочке), у системы - общий. Когда лимит процесса исчерпан, socket() и accept() возвращают EMFILE, системы целиком - ENFILE. Типичные причины: утечка (ответы не закрываются, тела не дочитываются) или пул без верхней границы.
Очереди на сервере: backlog
Когда клиент присылает SYN, соединение у сервера проходит через две очереди. SYN-очередь - полуоткрытые соединения, ждущие последнего ACK; её размер связан с net.ipv4.tcp_max_syn_backlog. Accept-очередь - полностью установленные соединения, которые приложение ещё не забрало вызовом accept(); её размер задаёт приложение в listen(backlog), но не больше net.core.somaxconn. По умолчанию somaxconn равен 4096 с Linux 5.4, а до этого был 128.
Что происходит при переполнении, неочевидно: по умолчанию (tcp_abort_on_overflow = 0) Linux не шлёт RST, а просто отбрасывает пакет, надеясь, что клиент повторит и к тому времени очередь освободится. Поэтому перегруженный сервер выглядит для клиента не как отказ, а как медленный connect или таймаут. Это та самая ситуация «тишина на connect», только сервер жив.
NAT и conntrack
Если между вами и интернетом стоит NAT (домашний роутер, облачный NAT-шлюз, Docker, Kubernetes), он помнит каждое соединение в таблице, чтобы знать, куда отдавать ответные пакеты. В Linux это подсистема conntrack, и у таблицы есть предел net.netfilter.nf_conntrack_max. Когда таблица полна, ядро пишет в dmesg «nf_conntrack: table full, dropping packet» и молча отбрасывает новые соединения. Симптом - таймауты на connect при живом сервере, причём на совершенно разных хостах одновременно.
Вторая проблема NAT - забывчивость. Запись о простаивающем соединении удаляется по таймауту. Если ваш пул держит соединение дольше, следующий запрос по нему либо пропадёт в тишине (read timeout), либо получит RST - зависит от реализации NAT. Лечится тем же правилом: idle timeout пула меньше, чем у всего, что стоит по пути.
Прокси, CDN и ограничение по IP
Прокси и CDN завершают ваше TCP-соединение у себя и открывают своё к приложению. Поэтому сетевые ошибки по ту сторону прокси вы видите в виде HTTP-статусов: 502 (не смог соединиться или получил мусор), 504 (не дождался ответа). У некоторых CDN есть свои нестандартные коды 5xx для тех же ситуаций, их стоит поискать в документации.
Ограничение частоты запросов (rate limiting) тоже бывает разным. Вежливый вариант - ответ 429 с Retry-After. Но защита от DDoS или firewall уровня TCP может ограничивать по IP грубо: сбрасывать соединения через RST или молча отбрасывать SYN. Тогда вместо понятного 429 вы видите ECONNRESET, ECONNREFUSED или таймауты, которые начинаются при росте нагрузки и пропадают при её спаде.
Как это выглядит в разных языках
Ruby
Стандартный Net::HTTP по умолчанию ставит open_timeout, read_timeout и write_timeout по 60 секунд, keep_alive_timeout 2 секунды и max_retries = 1. Ошибки:
Errno::ECONNREFUSED,Errno::EHOSTUNREACHи другиеErrno::*- сырые коды ядра, с добавленным текстом «Failed to open TCP connection to host:port».Net::OpenTimeout- connect timeout.Net::ReadTimeoutиNet::WriteTimeout- таймауты чтения и записи.SocketError- ошибки DNS (с Ruby 3.3 конкретнее:Socket::ResolutionError, наследникSocketError).OpenSSL::SSL::SSLError- ошибки TLS.
Встроенный повтор Net::HTTP срабатывает на Net::ReadTimeout, IOError, EOFError, ECONNRESET, ECONNABORTED, EPIPE, ETIMEDOUT, SSL-ошибки и Timeout::Error, но только для идемпотентных методов (GET, HEAD, PUT, DELETE, OPTIONS, TRACE). Net::OpenTimeout и ECONNREFUSED он не повторяет. Неочевидное следствие: из-за max_retries = 1 GET с read_timeout = 10 может длиться больше 20 секунд.
Ещё одна ловушка: Net::HTTP.get(uri) открывает новое соединение на каждый вызов. Соединение переиспользуется только внутри блока Net::HTTP.start. Перед повторным использованием Net::HTTP проверяет, не пришёл ли от сервера конец потока, но гонка с FIN, который ещё летит по сети, остаётся.
require 'net/http'

uri = URI('https://api.example.com')
Net::HTTP.start(uri.host, uri.port, use_ssl: true,
                open_timeout: 3, read_timeout: 10, write_timeout: 10) do |http|
  failures = 0
  ids.each do |id|
    # одно соединение на весь цикл
    http.request(Net::HTTP::Get.new("/track/#{id}"))
  rescue Errno::ECONNREFUSED, Net::OpenTimeout, SocketError
    failures += 1   # запрос не ушёл: можно повторить позже
  rescue Net::ReadTimeout, Errno::ECONNRESET, EOFError
    failures += 1   # мог быть обработан
  end
end
Faraday с middleware faraday-retry по умолчанию делает 2 повтора, только для идемпотентных методов (delete get head options put), без паузы (interval = 0), и только для Errno::ETIMEDOUT, Timeout::Error, Faraday::TimeoutError и Faraday::RetriableResponse. Обратите внимание: Faraday::ConnectionFailed (в него завёрнуты и refused, и reset) в списке по умолчанию нет, и статусы 429 и 503 тоже не повторяются, пока вы не укажете retry_statuses.
conn = Faraday.new(url: 'https://api.example.com') do |f|
  f.request :retry, max: 3,
                    interval: 0.5, backoff_factor: 2, interval_randomness: 0.5,
                    exceptions: [Faraday::ConnectionFailed, Faraday::TimeoutError],
                    retry_statuses: [429, 503]
  f.options.open_timeout = 3
  f.options.timeout = 10
end
HTTParty работает поверх Net::HTTP, поэтому исключения те же, а соединение по умолчанию новое на каждый вызов.
Sidekiq - это внешний слой повторов: упавшая задача по умолчанию повторяется до 25 раз с паузой примерно count⁴ + 15 секунд плюс случайный разброс, в сумме около трёх недель. Отсюда два вывода. Повторяется вся задача целиком, поэтому она должна быть идемпотентной. И если внутри уже есть 3 повтора Faraday, умножайте: одна задача может сделать до сотни запросов. А задача, которая обрабатывает пакет из тысячи элементов и падает на первом сетевом сбое, при каждом повторе заново прогоняет все уже успешные элементы.
Go
Главная ловушка Go: у http.Client нулевой Timeout означает «без таймаута», и http.DefaultClient именно такой. При этом http.DefaultTransport ставит connect timeout 30 секунд, TLS handshake 10 секунд, MaxIdleConns 100 и IdleConnTimeout 90 секунд, а ResponseHeaderTimeout не задан. Ответа от зависшего сервера клиент по умолчанию будет ждать вечно.
Вторая ловушка - DefaultMaxIdleConnsPerHost = 2. Если вы делаете 50 параллельных запросов к одному хосту, после ответа в пуле останутся только 2 соединения, остальные 48 закроются, и на следующей волне откроются заново. Под нагрузкой это прямая дорога к TIME_WAIT и EADDRNOTAVAIL.
Автоматический повтор в Transport очень осторожный: только при сетевой ошибке на уже использованном соединении (тот самый случай с протухшим соединением), и только если запрос идемпотентный: методы GET, HEAD, OPTIONS, TRACE или заголовок Idempotency-Key / X-Idempotency-Key. Заметьте: PUT и DELETE в этом списке нет, в отличие от Ruby и Python.
client := &http.Client{
    Timeout: 15 * time.Second, // общий дедлайн
    Transport: &http.Transport{
        DialContext:           (&net.Dialer{Timeout: 3 * time.Second}).
                               DialContext,
        TLSHandshakeTimeout:   5 * time.Second,
        ResponseHeaderTimeout: 10 * time.Second,
        MaxIdleConnsPerHost:   32,
        IdleConnTimeout:       30 * time.Second,
    },
}

resp, err := client.Do(req)
if err != nil {
    var netErr net.Error
    var dnsErr *net.DNSError
    switch {
    case errors.Is(err, syscall.ECONNREFUSED): // не ушло
    case errors.As(err, &dnsErr):              // DNS
    case errors.Is(err, syscall.ECONNRESET):   // мог быть обработан
    case errors.As(err, &netErr) && netErr.Timeout():
    }
    return err
}
defer resp.Body.Close()
// без дочитывания тела соединение не вернётся в пул
io.Copy(io.Discard, resp.Body)
errors.Is работает через всю цепочку обёрток (*url.Error, *net.OpError, *os.SyscallError), поэтому сравнивать текст ошибки не нужно. Для общего дедлайна вместе с повторами удобно использовать context.WithTimeout и передавать контекст в каждую попытку через req.WithContext.
Node.js
Встроенный fetch в Node.js построен на библиотеке undici. Её значения по умолчанию: connectTimeout 10 секунд (ошибка UND_ERR_CONNECT_TIMEOUT), headersTimeout и bodyTimeout по 300 секунд, keepAliveTimeout 4 секунды. Сетевая ошибка в fetch выглядит как TypeError: fetch failed, а настоящий код лежит в err.cause.code:
try {
  const res = await fetch('https://api.example.com/track/42', {
    signal: AbortSignal.timeout(10_000) // общий дедлайн
  });
} catch (err) {
  if (err.name === 'TimeoutError') { /* сработал AbortSignal.timeout */ }
  // ECONNREFUSED, ECONNRESET, ENOTFOUND, EAI_AGAIN,
  // UND_ERR_CONNECT_TIMEOUT
  const code = err.cause?.code;
}
У старого модуля http свои особенности:
- Таймаута ответа по умолчанию нет. Его надо задать через опцию
timeoutилиsignal. - С Node.js 19 глобальный агент
http.globalAgentиспользует keep-alive с таймаутом простоя 5 секунд. До этого соединения по умолчанию не переиспользовались. - Если сервер закрыл соединение до ответа, вы получите ошибку
socket hang upс кодомECONNRESET. - DNS-ошибка «имя не найдено» в Node.js называется
ENOTFOUND, а временная -EAI_AGAIN. - Если у хоста несколько адресов (например, IPv4 и IPv6 у
localhost), свежие версии Node.js пробуют их по очереди, и при общей неудаче может прийтиAggregateErrorс отдельными ошибками вerr.errors.
Из популярных клиентов got повторяет из коробки: 2 повтора, только идемпотентные методы, коды ETIMEDOUT, ECONNRESET, ECONNREFUSED, EPIPE, ENOTFOUND, ENETUNREACH, EAI_AGAIN и другие, статусы 408, 413, 429, 500, 502, 503, 504, с учётом Retry-After. axios сам не повторяет, обычно добавляют axios-retry. Там ловушка: условие по умолчанию повторяет сетевые ошибки для любого метода, включая POST, а проверку идемпотентности применяет только к ответам 5xx. И пауза по умолчанию нулевая.
Python
requests по умолчанию не имеет таймаута вообще: без параметра timeout запрос может висеть бесконечно. И не повторяет: у HTTPAdapter max_retries по умолчанию 0. Повторы настраиваются через класс Retry из urllib3, и он хорошо отражает идеи этой статьи: ошибки соединения (connect) он повторяет для любого метода, потому что запрос не ушёл, а ошибки чтения (read) - только для методов из allowed_methods (по умолчанию HEAD, GET, PUT, DELETE, OPTIONS, TRACE). Retry-After учитывается для 413, 429 и 503, а backoff_factor по умолчанию 0, то есть без паузы.
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

retry = Retry(total=3, connect=3, read=1, backoff_factor=0.5,
              status_forcelist=[429, 503])
session.mount("https://", HTTPAdapter(max_retries=retry))
session.get(url, timeout=(3, 10))  # (connect, read)
Java и пулы соединений к базе
В java.net.http.HttpClient оба таймаута по умолчанию не заданы: connect timeout ставится через HttpClient.newBuilder().connectTimeout(...), таймаут ответа - через HttpRequest.newBuilder().timeout(...). Отказ соединения приходит как java.net.ConnectException, таймауты - как HttpConnectTimeoutException и HttpTimeoutException.
Всё сказанное о пулах относится и к соединениям с базой данных. Пул HikariCP держит соединение максимум maxLifetime (по умолчанию 30 минут), и документация прямо просит ставить это значение на несколько секунд меньше любого лимита, который наложат база или сетевая инфраструктура: NAT, firewall, прокси. Не путайте с connectionTimeout (по умолчанию 30 секунд) - это время ожидания свободного соединения из пула, а не сетевой таймаут.
Чеклист для продакшена
- Задайте все таймауты: connect, read, write и общий дедлайн на операцию с повторами. Значения по умолчанию часто равны «бесконечности» или нескольким минутам.
- Повторяйте только безопасные стадии. Всё, что упало до отправки запроса, можно повторить. Всё, что после, - только если операция идемпотентна или у неё есть ключ идемпотентности.
- Добавьте jitter к экспоненциальной паузе и уважайте
Retry-After. - Ограничьте повторы: не больше 2-3 попыток, повторы только в одном слое, общий бюджет времени.
- Логируйте класс ошибки, стадию и длительность попытки. «ECONNREFUSED за 0,3 мс» и «timeout за 10 с» - разные инциденты.
- Считайте неудачи, а не прерывайте пакет. Одна ошибка не должна откатывать тысячу успешных операций.
- Алертите на серию, а не на один сбой. Одиночный отказ во время деплоя - норма, рост доли ошибок за 5-10 минут - повод разбираться.
- Переиспользуйте соединения и делайте idle timeout клиента меньше, чем у сервера и всего, что стоит между вами.
Источники
- RFC 9293 - Transmission Control Protocol (рукопожатие, RST, TIME_WAIT)
- RFC 9110 - HTTP Semantics (идемпотентные методы 9.2.2, Retry-After 10.2.3, 502/503/504)
- RFC 6585 - Additional HTTP Status Codes (429)
- IETF draft - The Idempotency-Key HTTP Header Field
- connect(2), tcp(7), socket(7), getaddrinfo(3)
- Linux kernel - IP sysctl (ip_local_port_range, somaxconn, tcp_abort_on_overflow, tcp_syn_retries, tcp_tw_reuse)
- Linux kernel - Netfilter conntrack sysctl
- Ruby net-http, исходный код (значения по умолчанию, IDEMPOTENT_METHODS_, transport_request)
- faraday-retry
- Sidekiq - Error Handling
- Puma - значения конфигурации по умолчанию
- Go net/http (Client.Timeout, DefaultTransport, DefaultMaxIdleConnsPerHost, правила повтора Transport)
- Node.js http, Node.js common system errors, undici Client
- got - retry, axios-retry
- urllib3 Retry, requests - Timeouts
- Java HttpClient.Builder, HikariCP
- nginx keepalive_timeout
- Exponential Backoff And Jitter
- Google SRE Book - Handling Overload, Addressing Cascading Failures
- Martin Fowler - CircuitBreaker