
Vision-Language-Action workshop (16 октября 2026)
Сходил на очередную встречу Tallinn Robotics & Computer Vision - Vision-Language-Action models for robot manipulation tasks. Вёл её снова Sergii Kharagorgiiev, в той же лаборатории, что и Robot Actuators Workshop. На этот раз пришло около 10 человек.
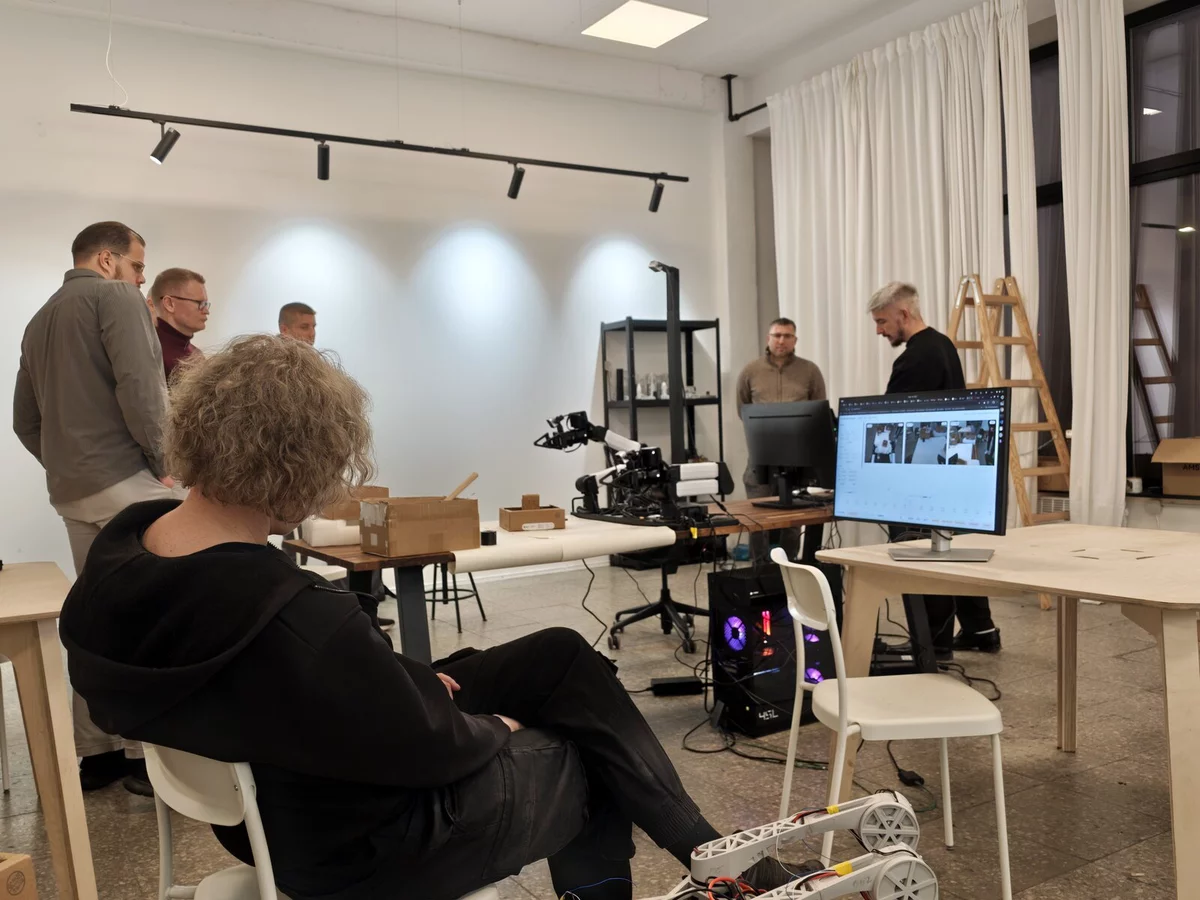
Тема - VLA-модели (Vision-Language-Action), то есть языковые модели со зрением, которые выдают не текст, а движения для робота. Перед встречей я собрал информацию по компаниям и исследованиям, которые упоминались, и из этого получилась отдельная статья: VLA-модели для роботов: что происходит в индустрии и как собрать сортировщика на коленке.
Станция
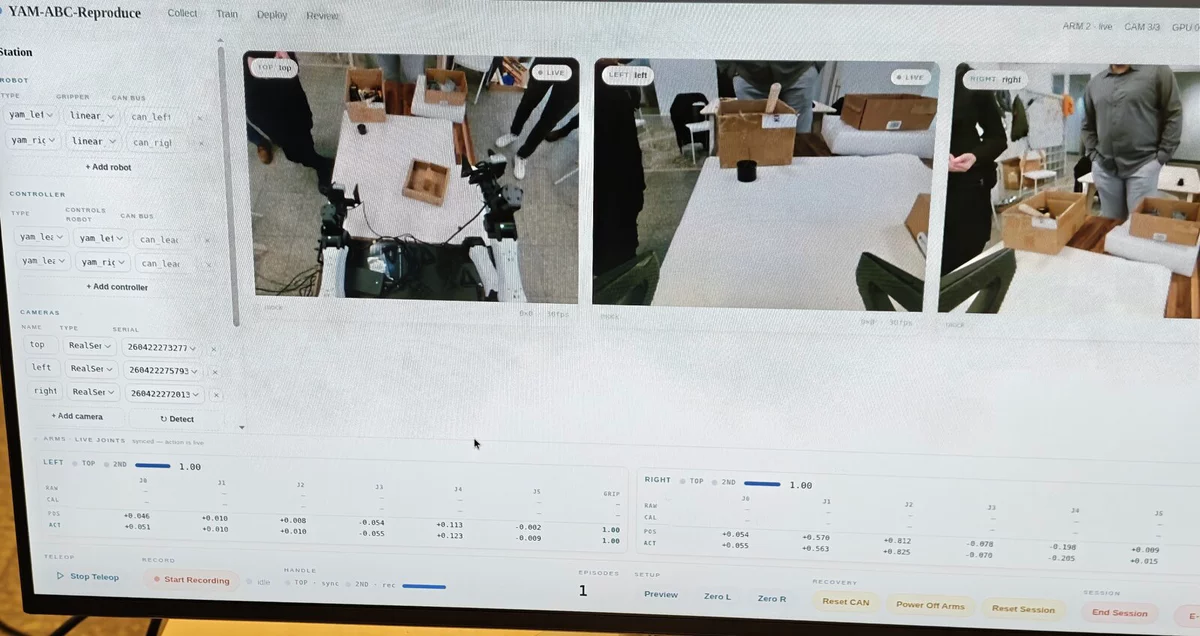
У Сергея двурукая станция YAM Box от i2rt и Nvidia RTX 5090, на которой он прогоняет разные VLA-модели. Камер три: по одной на каждом запястье и одна сверху.
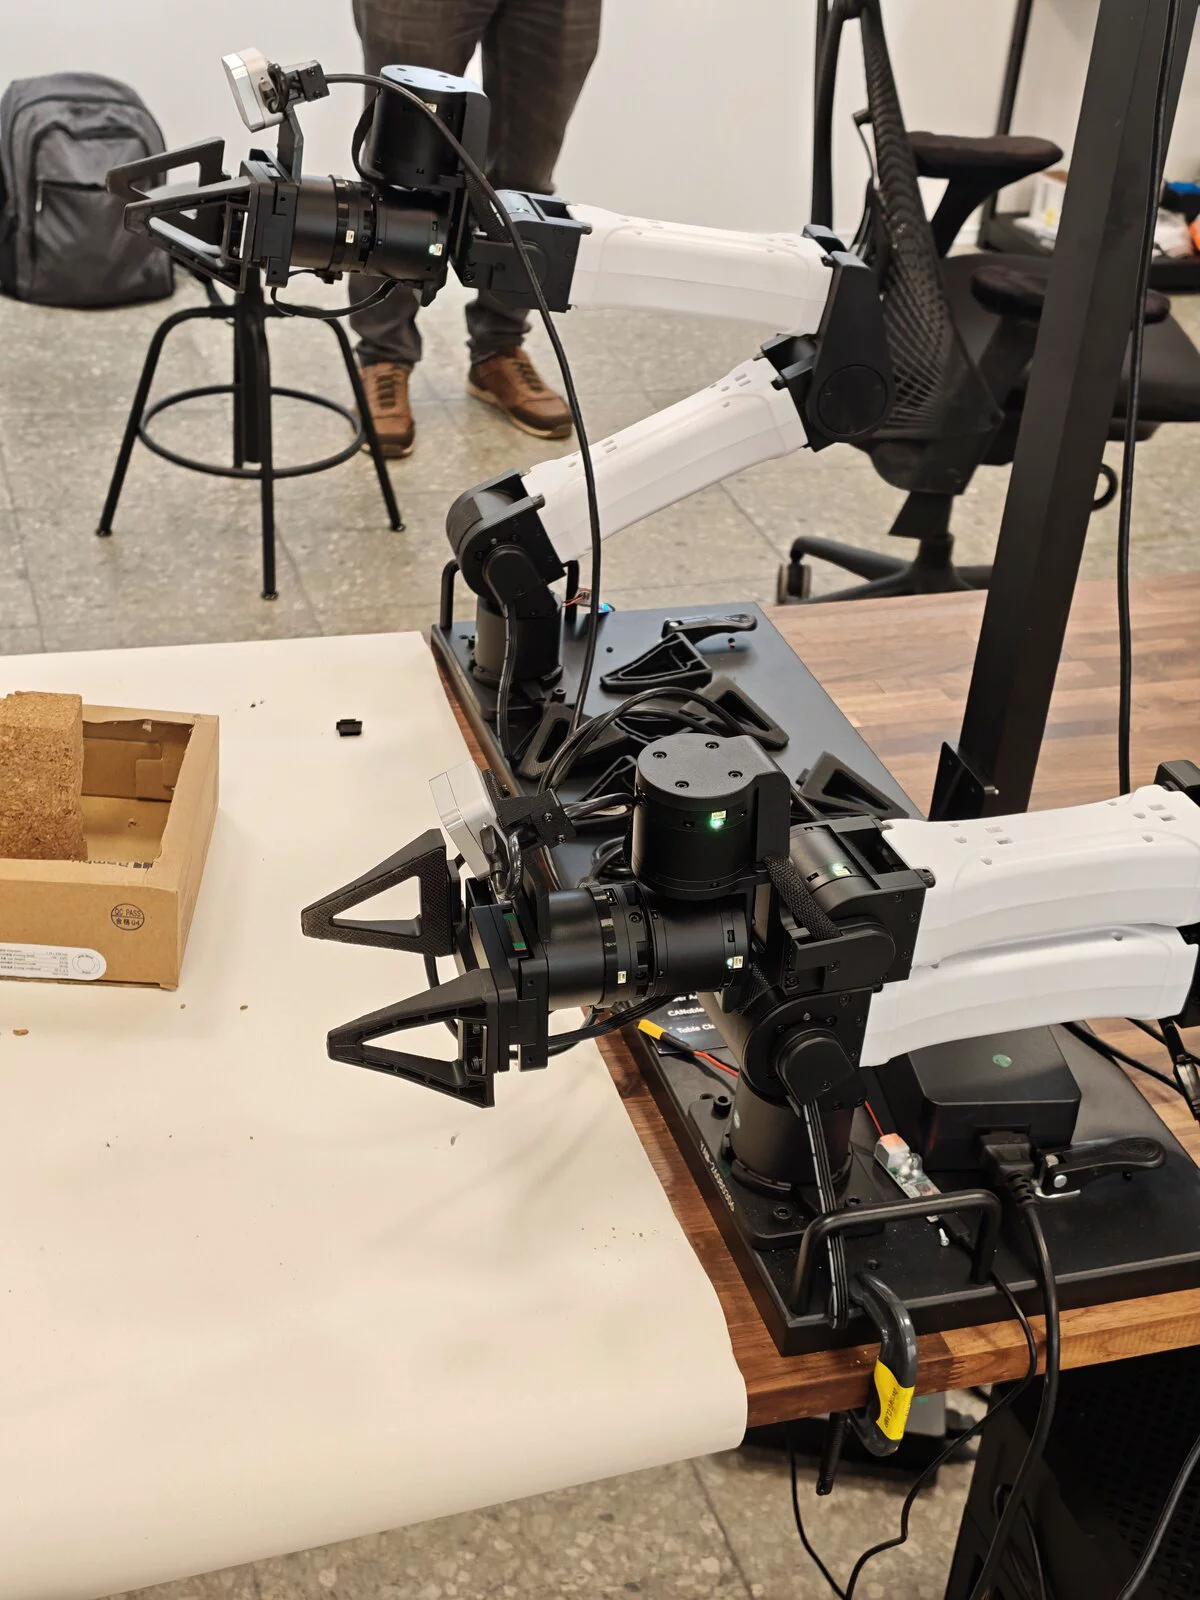
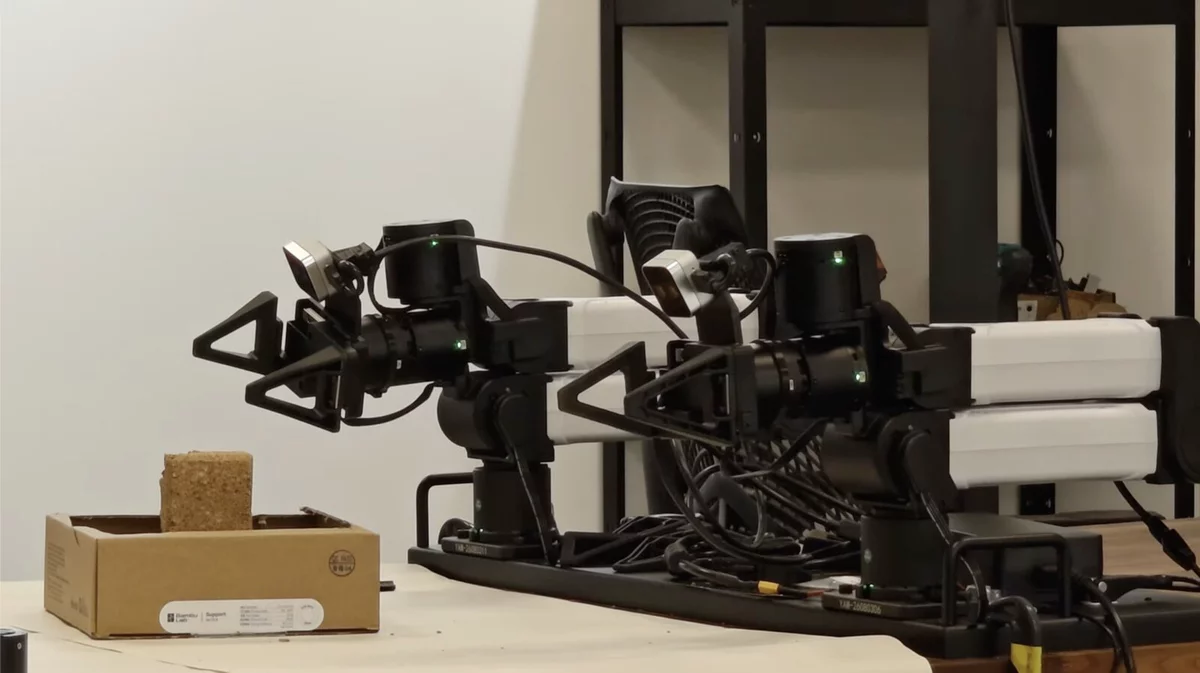
Весь цикл - запись демонстраций, обучение, деплой и просмотр эпизодов - идёт через yam-abc-reproduce. Человек управляет роботом через ведущие руки, а программа пишет видео со всех камер и положения суставов. Так датасет создают обычные люди простой записью своих действий, и обучение моделей заметно дешевеет: не нужны ни разметка, ни дорогие лаборатории.
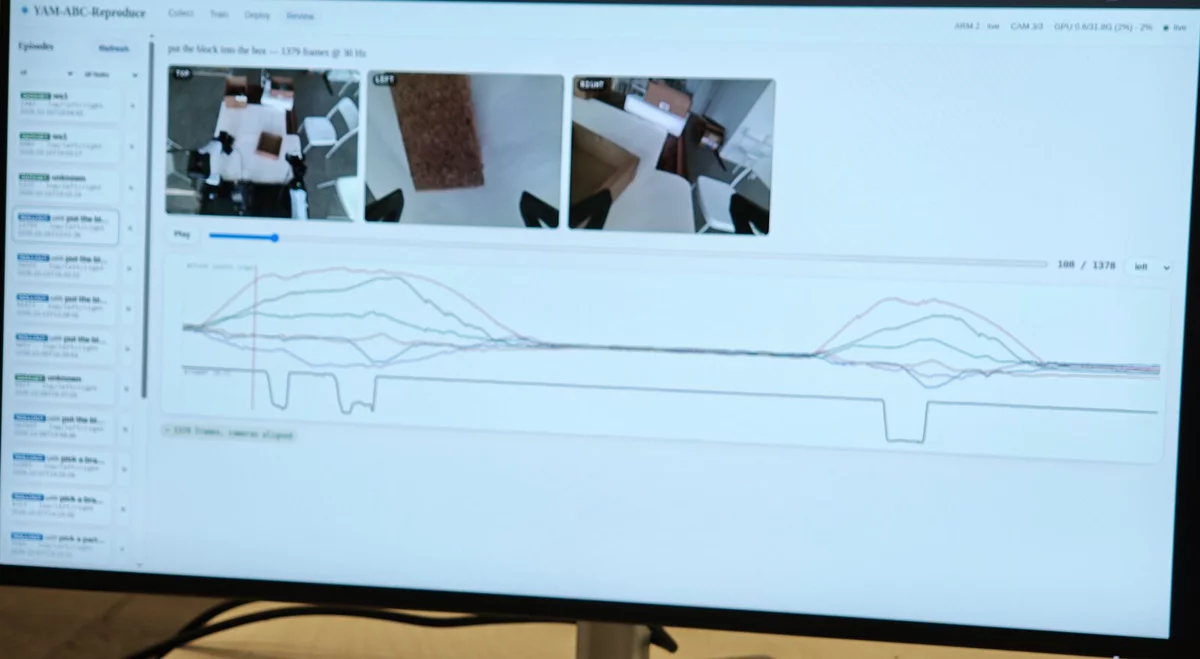
Как это работает и почему пока «глупо»
Сергей честно показал, что модели пока довольно узкие. Их обучают на конкретных действиях - взять кубик и положить в коробку, - и с другими задачами они справляются плохо. Детали у разных моделей отличаются, но суть одна: глядя на кадры с камер, модель строит траекторию оптимального движения, робот проходит её часть, и через несколько кадров пересчёт повторяется. В итоге выходит порядка 10 кадров в секунду, так что до настоящего realtime пока далеко.
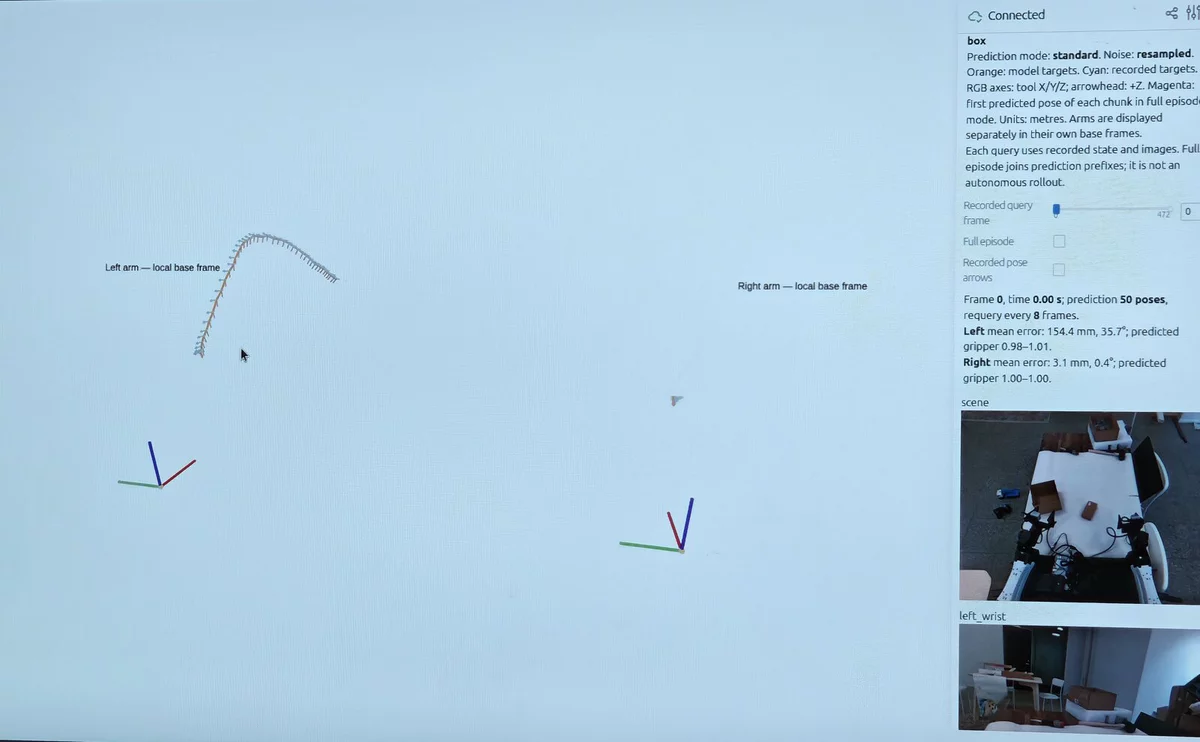
Главная проблема - стабильность. Публичные датасеты содержат тысячи часов видео, но, например, сняты на белом фоне, и модель становится к нему чувствительной. Я сталкивался с тем же лет пять назад, когда пытался прикрутить BeeAlarmed к своим ульям: обучение там было привязано к зелёному фону, и у меня оно работало плохо.
Мои мысли
- Слишком много видеопотоков. Три камеры дают большую нагрузку на обработку видео. Мне кажется, в идеале хватит одной стереокамеры плюс датчики нажатия в захвате.
- Геометрия важна. Для таких моделей критичны расстояние между руками и положение камеры - всё должно совпадать с тем, на чём записывали данные.
- Руки поинтереснее. Было бы интересно попробовать не простой двухпальцевый захват, а кисть с несколькими пальцами и тактильной обратной связью. Тогда можно делать гораздо более сложные вещи.
Робо-собака
Под конец кто-то из Тартуского университета принёс робо-собаку (похоже, Unitree Go2), и было интересно посмотреть, как она устроена.
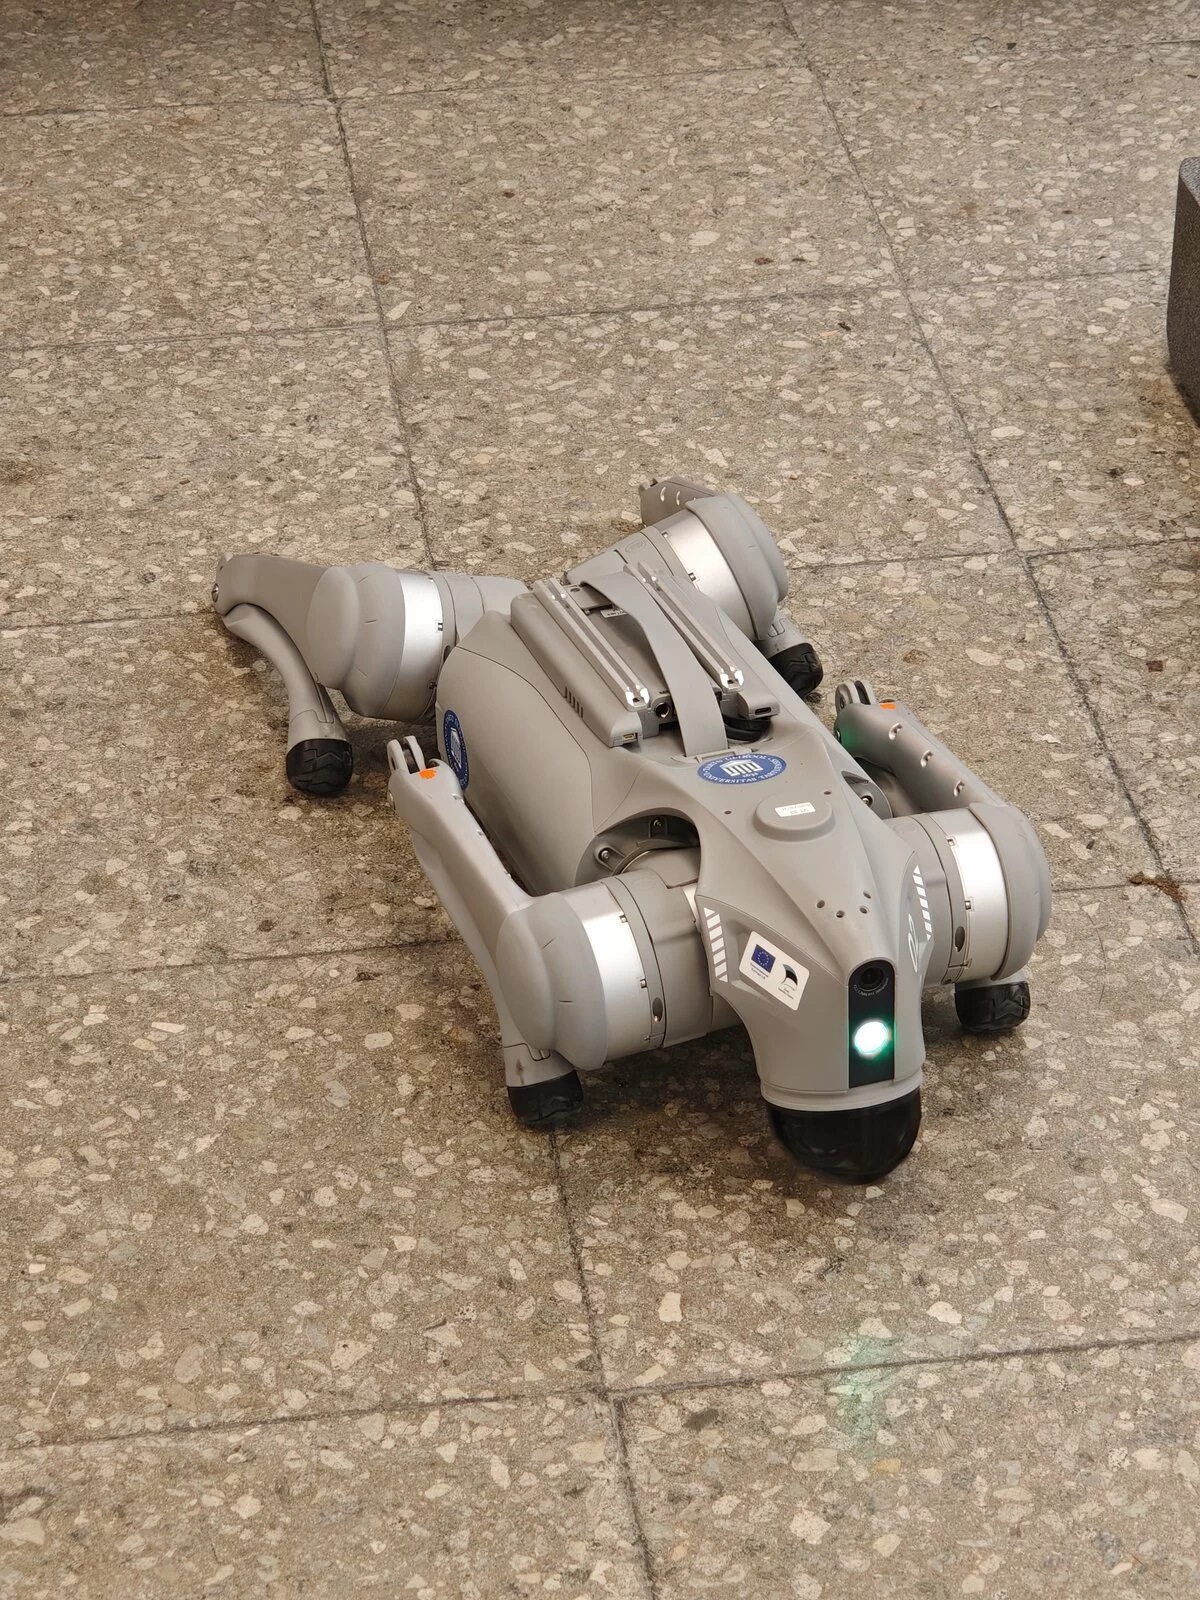
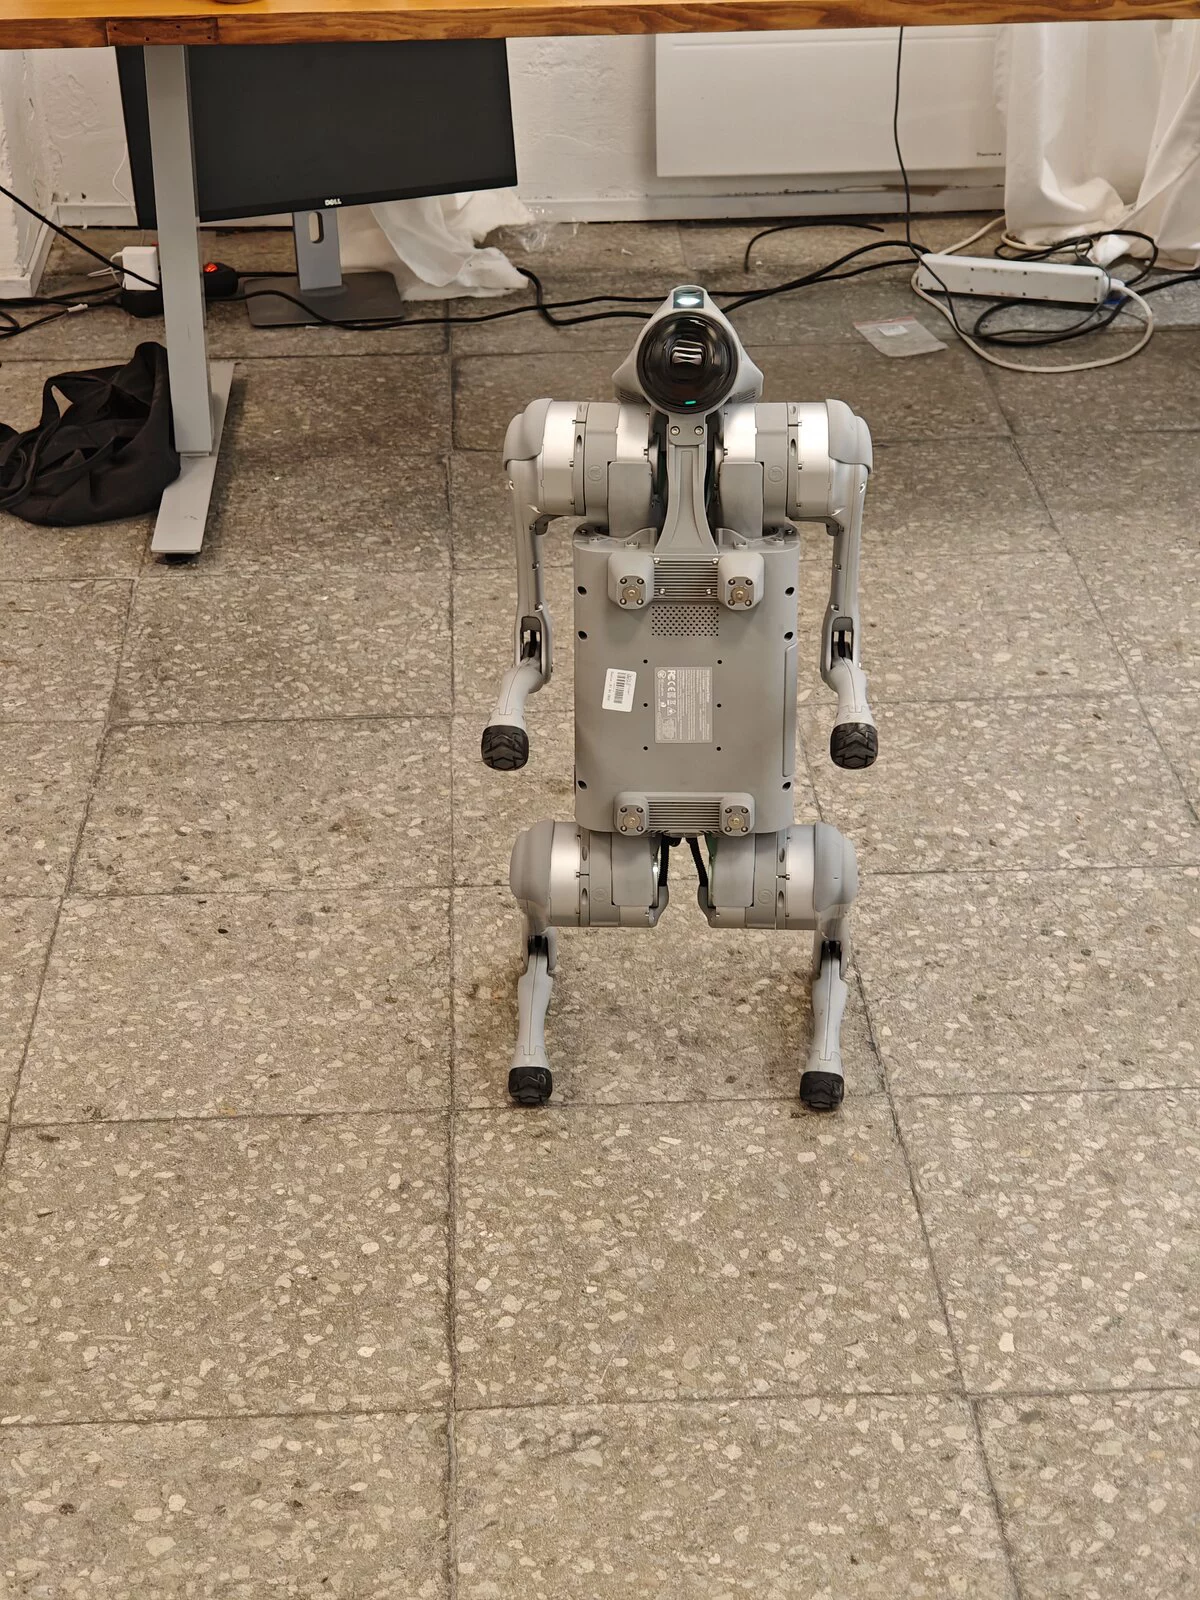
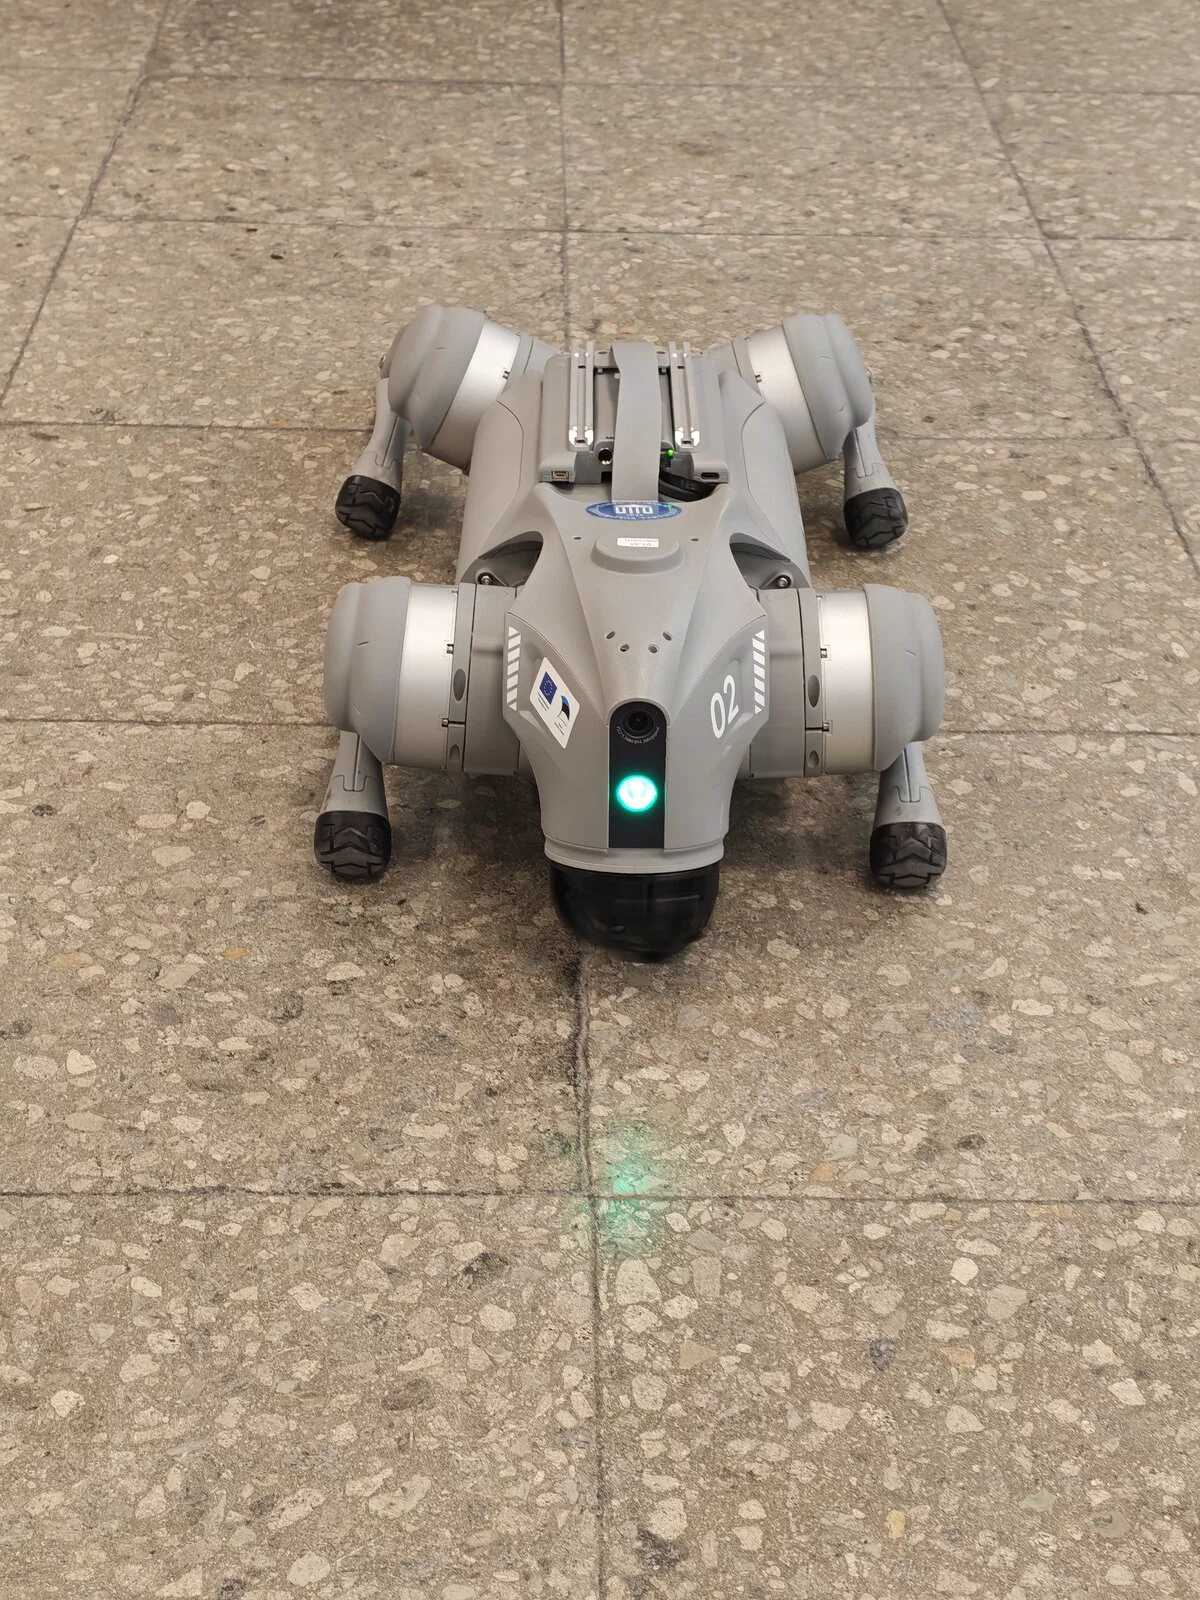
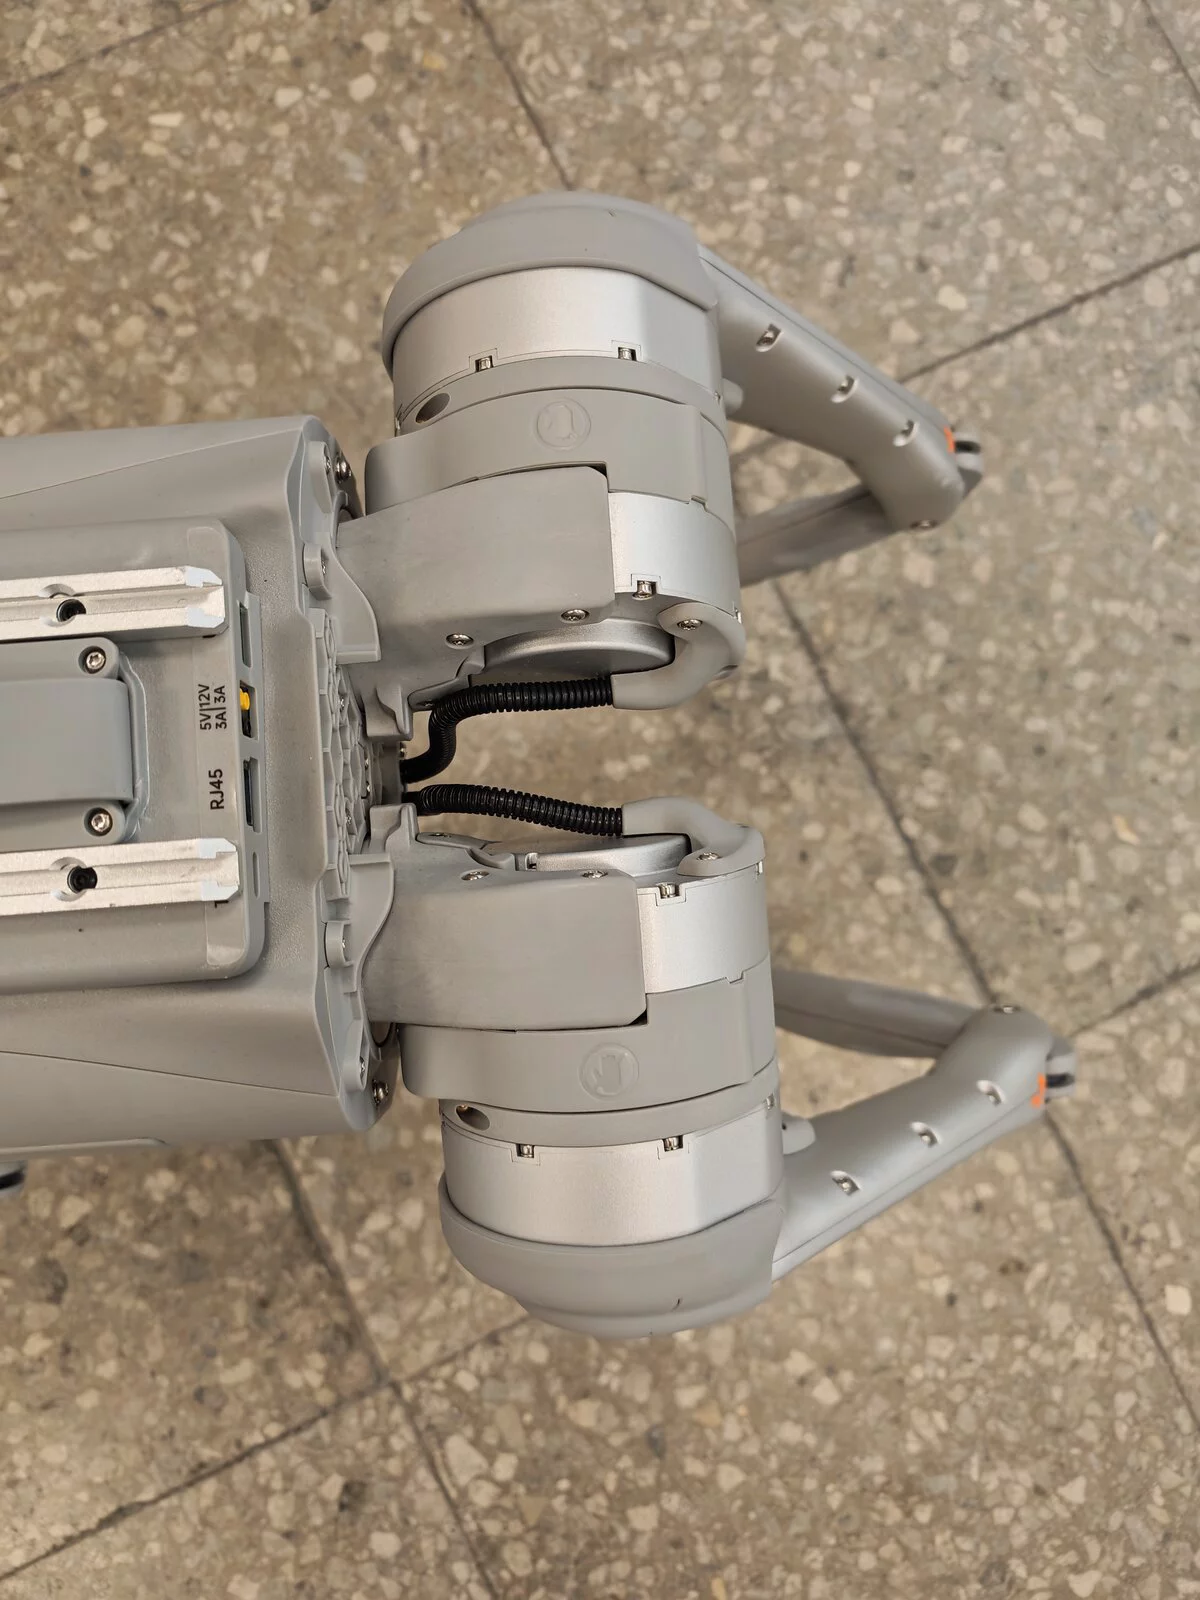
- Управляется с пульта, ИИ внутри нет, умных функций почти никаких.
- Спереди вращающийся лидар: в стены собака не врезается, а вот задом может.
- Человека на себе не унесёт, но что-то небольшое - вполне.
- Батареи хватает на несколько часов, автозарядки нет.
- Стоит дорого.
Если прикрутить сверху такую руку, как у Сергея, получилась бы куда более полезная машина.